Domain staubsaugerfiltertüten.de kaufen?
Wir ziehen mit dem Projekt
staubsaugerfiltertüten.de um.
Sind Sie am Kauf der Domain
staubsaugerfiltertüten.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain staubsaugerfiltertüten.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Was sind die gängigsten Programmierschnittstellen zum Zugriff auf externe Datenquellen?
Die gängigsten Programmierschnittstellen zum Zugriff auf externe Datenquellen sind RESTful APIs, SOAP APIs und ODBC/JDBC. RESTful APIs sind leicht zu implementieren und weit verbreitet, SOAP APIs bieten eine standardisierte Kommunikationsschnittstelle und ODBC/JDBC ermöglichen den Zugriff auf relationale Datenbanken. **

Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
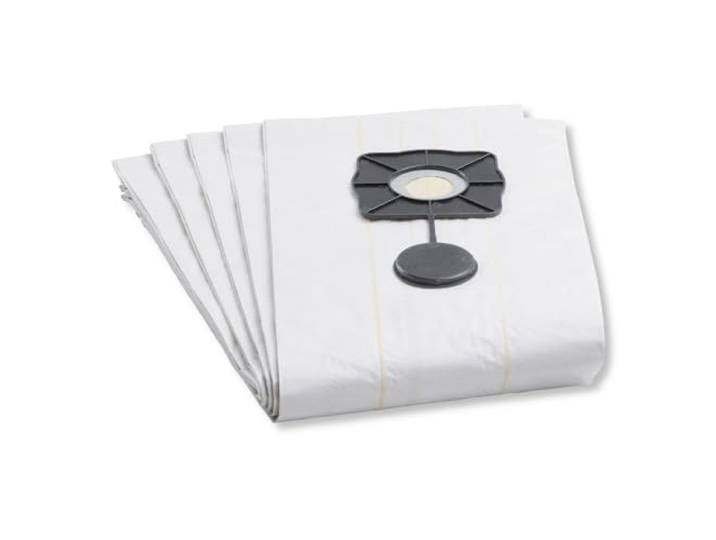
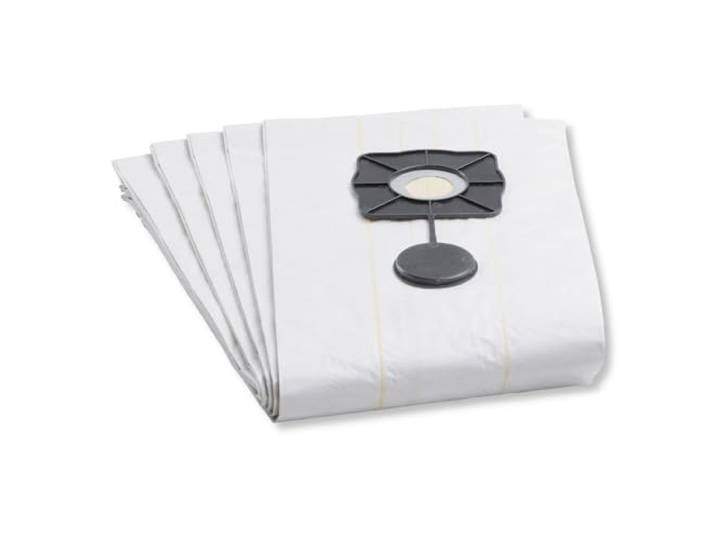
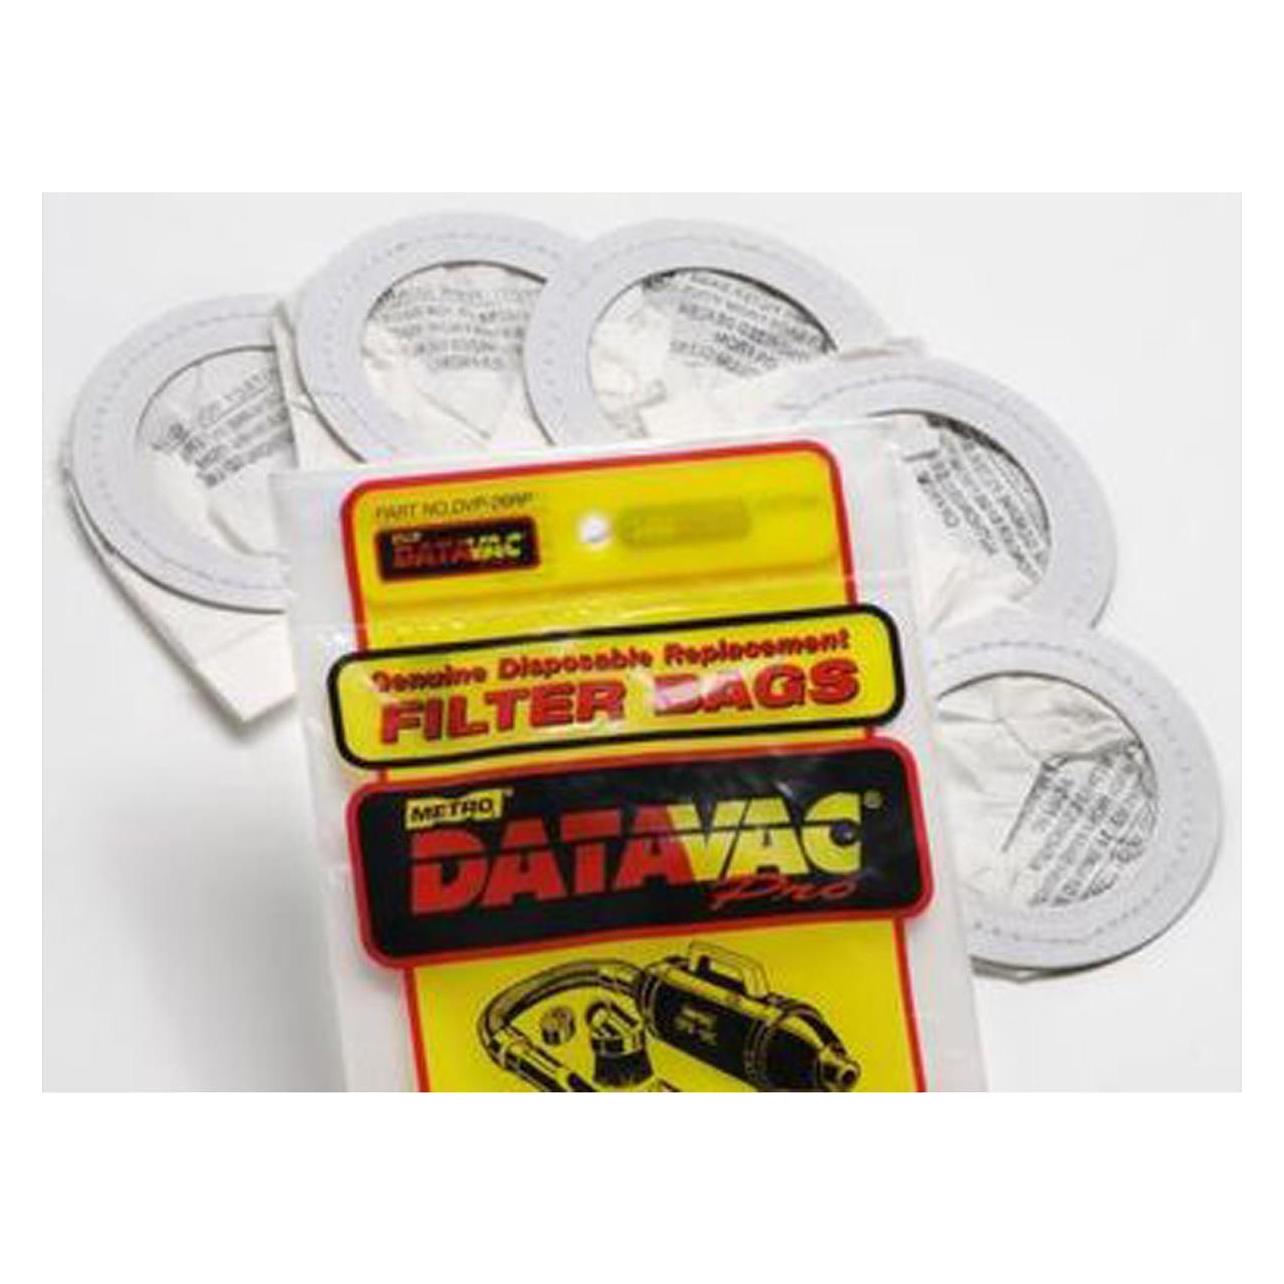
5 Vlies-Staubsaugerbeutel für Kärcher NT 611 KF Filtertüten5 Vlies-Staubsaugerbeutel für Kärcher NT 611 KF Filtertüten. Original Staubsaugerbeutel\nLieferumfang: 5 Stück, aus reißfestem Vliesmaterial\nErsatzteilnummer: 6.904-211.0\nSpezial-Nassfilterbeutel der Staubklasse L – für Trocken- und Nassreinigung geeignet88,15 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
5 Vlies-Staubsaugerbeutel für Kärcher NT 611 Eco KF Filtertüten5 Vlies-Staubsaugerbeutel für Kärcher NT 611 Eco KF Filtertüten. Original Staubsaugerbeutel\nLieferumfang: 5 Stück, aus reißfestem Vliesmaterial\nErsatzteilnummer: 6.904-211.0\nSpezial-Nassfilterbeutel der Staubklasse L – für Trocken- und Nassreinigung geeignet88,15 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können verschiedene Datenquellen effizient miteinander abgeglichen und synchronisiert werden?
Durch die Verwendung von Datenintegrations-Tools können verschiedene Datenquellen miteinander verbunden und synchronisiert werden. Diese Tools ermöglichen es, Daten aus verschiedenen Quellen zu extrahieren, zu transformieren und zu laden, um konsistente und aktuelle Informationen zu gewährleisten. Automatisierte Prozesse können dabei helfen, den Abgleich und die Synchronisierung effizient durchzuführen. **
-
Was sind die wichtigsten Schritte beim Verknüpfungsvorgang von verschiedenen Datenquellen?
Die wichtigsten Schritte beim Verknüpfungsvorgang von verschiedenen Datenquellen sind die Identifizierung der gemeinsamen Schlüssel, die Auswahl des richtigen Verknüpfungstyps (z.B. innerer Join, äußerer Join), und die Überprüfung der Datenintegrität nach der Verknüpfung. Es ist wichtig, sicherzustellen, dass die Daten korrekt und konsistent verknüpft werden, um genaue Analysen und Berichte zu erhalten. **
-
Welche Datenquellen und Methoden werden zur Erhebung von Wirtschaftsdaten verwendet?
Für die Erhebung von Wirtschaftsdaten werden primär offizielle Statistiken, Unternehmensberichte, Umfragen und Datenbanken genutzt. Zudem kommen auch Big Data-Analysen, Web-Scraping und Social Media Monitoring zum Einsatz. Die Methoden reichen von traditionellen Befragungen und Beobachtungen bis hin zu modernen Technologien wie Machine Learning und künstlicher Intelligenz. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
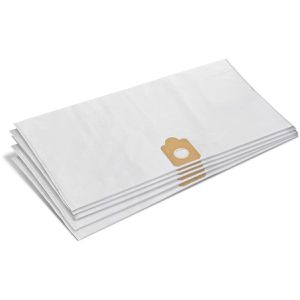
Monzana monzana 3 Staubsaugerbeutel Filtertüten Staubsaugertüten StaubbeutelSchont die Umwelt! Der Verschluss ist aus Pappe und nicht, wie üblich, aus Plastik; das schont die Umwelt! Der Beutel ist 5-lagig mit Mikrofilter und hat sehr hohe Saug- und Filtrationseigenschaften. Der strapazierfähige Staubbeutel sorgt auch bei vollem Inhalt jederzeit für eine hohe Saugkraft. 5-lagig mit Mikrofilter Pappverschluss kein Plastikmüll Schont die Umwelt hohe Saugkraft und Filtration Lange Nutzungsdauer4,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
5 Vlies-Staubsaugerbeutel für Kärcher NT 611 KF Filtertüten5 Vlies-Staubsaugerbeutel für Kärcher NT 611 KF Filtertüten. Original Staubsaugerbeutel\nLieferumfang: 5 Stück, aus reißfestem Vliesmaterial\nErsatzteilnummer: 6.904-211.0\nSpezial-Nassfilterbeutel der Staubklasse L – für Trocken- und Nassreinigung geeignet88,15 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
5 Vlies-Staubsaugerbeutel für Kärcher NT 611 Eco KF Filtertüten5 Vlies-Staubsaugerbeutel für Kärcher NT 611 Eco KF Filtertüten. Original Staubsaugerbeutel\nLieferumfang: 5 Stück, aus reißfestem Vliesmaterial\nErsatzteilnummer: 6.904-211.0\nSpezial-Nassfilterbeutel der Staubklasse L – für Trocken- und Nassreinigung geeignet88,15 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Was sind die gängigsten Programmierschnittstellen zum Zugriff auf externe Datenquellen?
Die gängigsten Programmierschnittstellen zum Zugriff auf externe Datenquellen sind RESTful APIs, SOAP APIs und ODBC/JDBC. RESTful APIs sind leicht zu implementieren und weit verbreitet, SOAP APIs bieten eine standardisierte Kommunikationsschnittstelle und ODBC/JDBC ermöglichen den Zugriff auf relationale Datenbanken. **
-
Wie können verschiedene Datenquellen effizient miteinander abgeglichen und synchronisiert werden?
Durch die Verwendung von Datenintegrations-Tools können verschiedene Datenquellen miteinander verbunden und synchronisiert werden. Diese Tools ermöglichen es, Daten aus verschiedenen Quellen zu extrahieren, zu transformieren und zu laden, um konsistente und aktuelle Informationen zu gewährleisten. Automatisierte Prozesse können dabei helfen, den Abgleich und die Synchronisierung effizient durchzuführen. **
-
Was sind die wichtigsten Schritte beim Verknüpfungsvorgang von verschiedenen Datenquellen?
Die wichtigsten Schritte beim Verknüpfungsvorgang von verschiedenen Datenquellen sind die Identifizierung der gemeinsamen Schlüssel, die Auswahl des richtigen Verknüpfungstyps (z.B. innerer Join, äußerer Join), und die Überprüfung der Datenintegrität nach der Verknüpfung. Es ist wichtig, sicherzustellen, dass die Daten korrekt und konsistent verknüpft werden, um genaue Analysen und Berichte zu erhalten. **
Ähnliche Suchbegriffe für Datenquellen
-
MENZER Staubsaugerbeutel Vlies-Filtertüten, für Nass-Trockensauger VCL & VCM 330 Serie, 5 StückVlies- Ersatzbeutel für Menzer VCL 330 & VCM 330 Merkmale: geeignet für: Menzer VCM 330, Menzer VCL 330 weitere Produktinformationen: Material: Vlies Inhalt: 5 Stück,25,29 €*Versand: 4,15 €Sichere Weiterleitung zum Anbieter
-
Welche Datenquellen und Methoden werden zur Erhebung von Wirtschaftsdaten verwendet?
Für die Erhebung von Wirtschaftsdaten werden primär offizielle Statistiken, Unternehmensberichte, Umfragen und Datenbanken genutzt. Zudem kommen auch Big Data-Analysen, Web-Scraping und Social Media Monitoring zum Einsatz. Die Methoden reichen von traditionellen Befragungen und Beobachtungen bis hin zu modernen Technologien wie Machine Learning und künstlicher Intelligenz. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.